什么时候该建模,什么时候不该
建模不是越多越好。判断标准只有三条,任何一条不满足,花钱建模都是浪费。
被问得最多的问题不是“你们能不能做”,而是“我这个问题值不值得做”。我们内部的判断标准很简单,三条,缺一条就劝退。
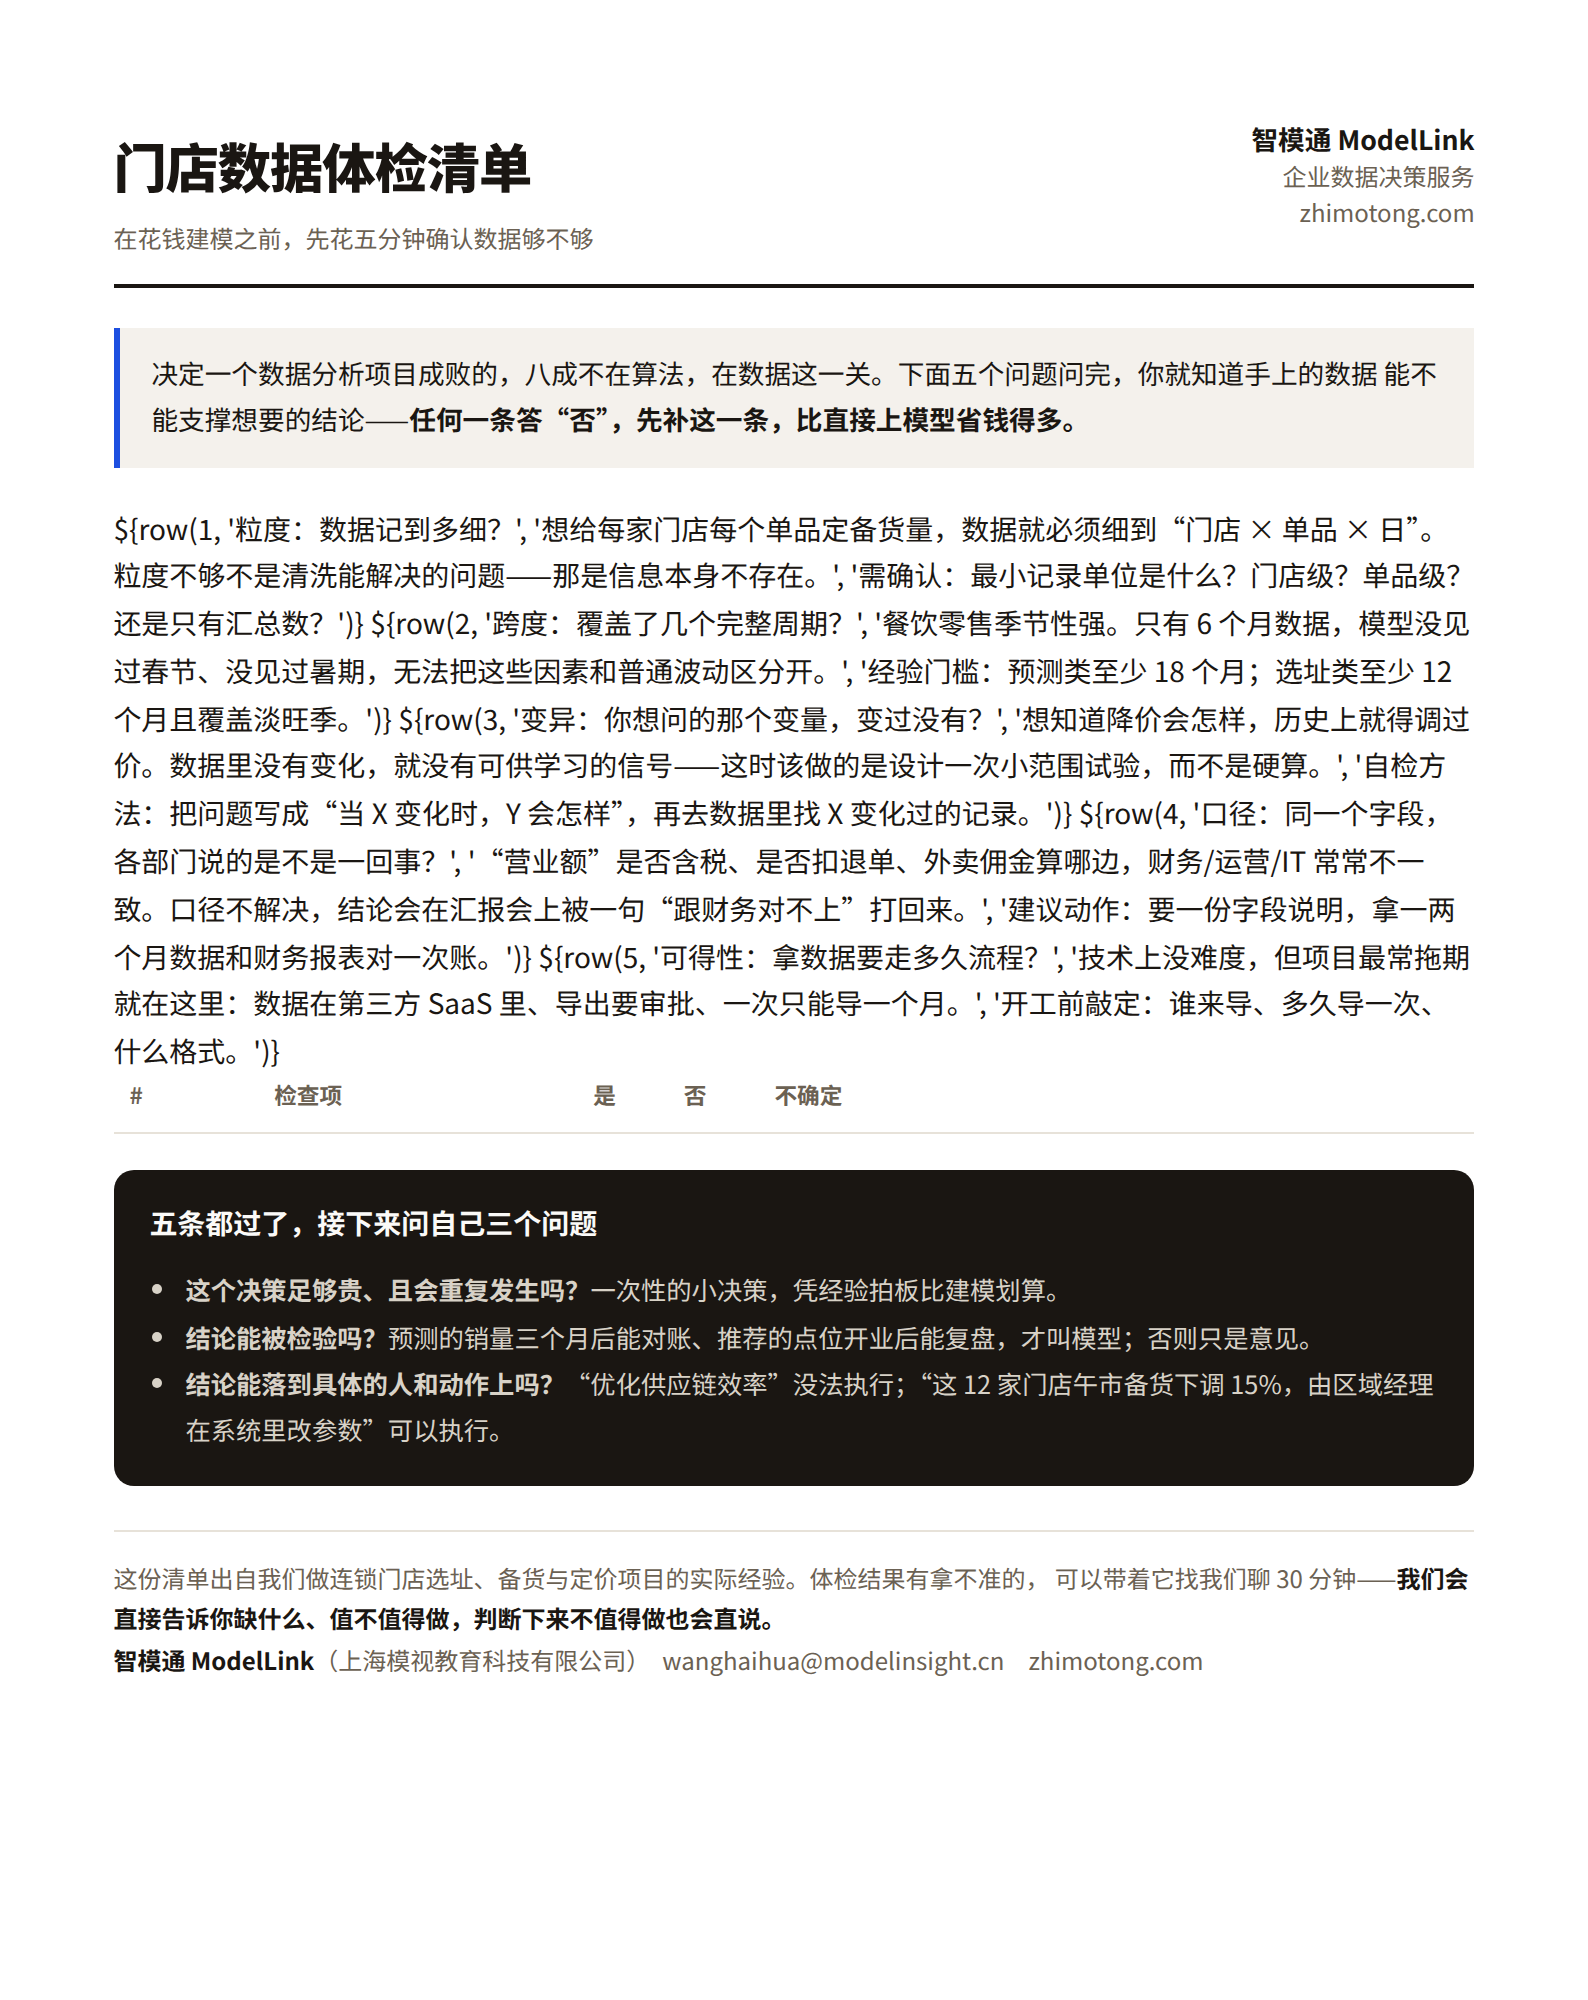
第一条:这个决策足够贵,且会重复发生
建模的成本是固定的,收益却取决于决策的金额和频次。开一家店的错误成本是几十万,一年开三十家,这就值得算;办公室采购哪个品牌的打印机,一年一次、差价几千块,凭经验拍板更划算。
重复性尤其重要。一次性的决策就算金额大,模型也只用一次,摊销不下来;而备货这种每天都在做的决策,模型上线之后每天都在产生价值。所以我们更愿意接“高频 × 中等金额”的项目,而不是“一次性 × 大金额”的。
第二条:数据能覆盖你想问的那个变化
这条最容易被忽略。想知道“降价 10% 客流会怎么变”,前提是历史上价格变动过——如果三年没调过价,再多的交易数据也估不出弹性,因为数据里根本没有价格变化这个信号。同理,想预测新业态门店的销量,而你所有的历史门店都是同一种业态,模型只能外推,外推就意味着不确定性大到无法作为决策依据。
判断方法很直接:把你想问的问题写成“当 X 变化时,Y 会怎样”,然后去数据里找 X 变化过的记录。找不到,就先设计一次小范围试验制造数据,而不是硬算。
第三条:结论能被检验,也能被执行
能被检验,指的是模型给出的答案在未来某个时点会被现实证实或证伪——预测的销量三个月后可以对账,推荐的点位开业后可以复盘。不能被检验的结论,本质上是意见不是模型。
能被执行,指的是结论落到具体的人和动作上。“建议优化供应链效率”没法执行;“这 12 家门店的午市备货量下调 15%,由区域经理在系统里改参数”可以执行。我们在立项阶段就会问:如果模型算出来是这个答案,谁在什么系统里改什么?答不上来,这个项目大概率会变成一份没人用的报告。
不该建模的时候,我们通常建议什么
- 问题其实是“看不清现状”,不是“算不出未来”——先把报表做对,成本低得多。
- 数据缺关键字段——先补数据采集,哪怕只是让店长每天多填一个字段,三个月后再来算。
- 决策的真正阻力是组织而不是信息——大家心里都知道该关掉哪几家店,缺的是拍板的人,不是模型。这种情况模型只会变成推卸责任的工具。
我们在第一次沟通里就会把这三条过一遍。判断下来不值得做,我们会直说——留住一个“这次没做成但记住你很实在”的客户,比做一个双方都不满意的项目划算。